K8s 设备插件
DevicePlugin 设备插件是一种扩展 k8s 硬件资源的办法。一个容器的资源类型默认有 cpu、mem 等,这些都是直接实现在 k8s 代码里的。通过往集群注入 DevicePlugin,就可以使用自定义的计算资源。
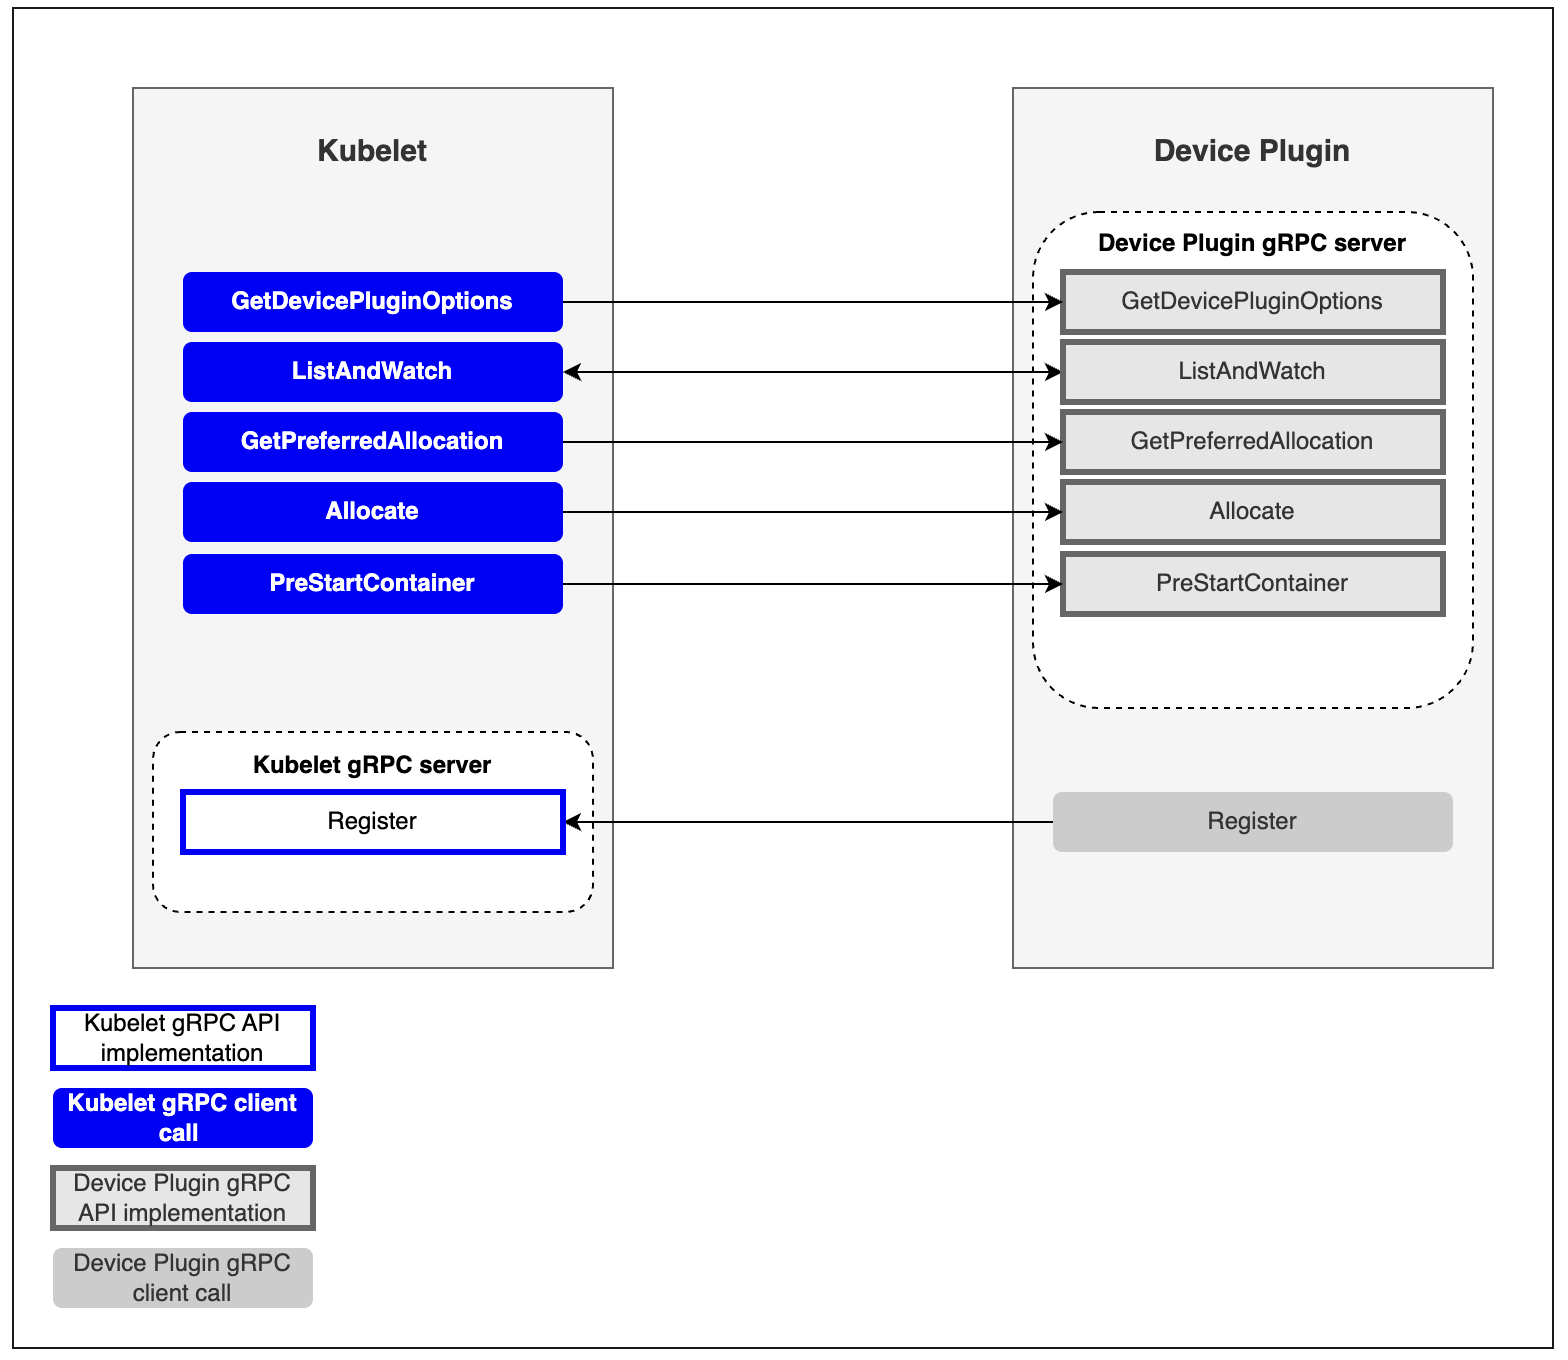
从官方文档设备插件 | Kubernetes,可以看到插件必须作为一个rpc服务,实现这些接口:
service DevicePlugin {
// GetDevicePluginOptions 指定插件的配置选项
rpc GetDevicePluginOptions(Empty) returns (DevicePluginOptions) {}
// ListAndWatch list+watch 可用的设备并监听变化
rpc ListAndWatch(Empty) returns (stream ListAndWatchResponse) {}
// Allocate 容器创建时,向插件请求分配设备资源
rpc Allocate(AllocateRequest) returns (AllocateResponse) {}
// GetPreferredAllocation kubelet提供一个设备列表,插件从中选取最适合的几个
rpc GetPreferredAllocation(PreferredAllocationRequest) returns (PreferredAllocationResponse) {}
// PreStartContainer 容器启动之前回调插件
rpc PreStartContainer(PreStartContainerRequest) returns (PreStartContainerResponse) {}
}其中,ListAndWatch 和 Allocate 这两个接口必须,其他可选。
Kubelet自身有一个注册插件接口,调用这个接口就可以注册设备插件:
service Registration {
   rpc Register(RegisterRequest) returns (Empty) {}
}
需要提供这个插件的 socket 地址、API版本和提供的资源名。kubelet 会使用 socket 地址来调用插件,并通过指定的资源名来匹配 resource req 写的资源,例如 nvidia.com/gpu。
需求
在编写 unicore 推理平台时,通过编写假 gpu 设备插件,可以在不使用真实 gpu 设备的同时模拟推理功能,完成后续的开发。
具体来说,我们需要一个调度器插件,在 kubelet 调用时,返回自己有4个 gpu 资源可供分配,允许 kubelet 调度、使用、回收,模拟真实的 gpu 生命周期场景。
预期流程:
插件在 /var/lib/kubelet/device-plugins/ 下建自己的 socket(virtual-gpu.sock)并开始监听
插件连 kubelet.sock 调 Register:“注册资源 unicore.mcyou.cc/gpu,socket 是 fake-gpu.sock”
kubelet 回连插件,调 ListAndWatch;插件发回 fake-0..3 的完整列表
kubelet 把 unicore.mcyou.cc/gpu: 4 写进 Node 的 capacity / allocatable
调度器只按“个数”把 Pod 放到这个节点
kubelet 自己从空闲设备里挑出 fake-2,调插件的 Allocate(["fake-2"])
插件返回“给容器设环境变量 VIRTUAL_GPU_IDS=fake-2”
容器启动,读到 VIRTUAL_GPU_IDS=fake-2
实现
插件本体必须要实现规定的五个方法,但这里只有 Allocate 和 ListAndWatch 是实际要处理的。我们在内存结构中记录 deviceID 列表,并虚拟出一个设备健康记录,供之后调试用。预留一个 updateCh,之后更新健康信息则调这里触发 list-watch。
const (
ResourceName = "unicore.mcyou.cc/gpu" // Pod 里写 limits["unicore.mcyou.cc/gpu"] 就是申请它
EnvAssigned = "VIRTUAL_GPU_IDS" // Allocate 返回的环境变量名
)
type VirtualGPUPlugin struct {
// 新版grpc要求嵌入,用于前向兼容
pluginapi.UnimplementedDevicePluginServer
mu sync.Mutex
deviceIDs []string // fake-0 fake-1 ...
health map[string]string // 虚拟的健康记录
updateCh chan struct{} // 有变化的时候通知 list-watch
}
func NewPlugin(n int) *VirtualGPUPlugin {
devices := make([]string, n)
healthMap := make(map[string]string)
for i := 0; i < n; i++ {
devices[i] = fmt.Sprintf("fake-%d", i)
healthMap[devices[i]] = pluginapi.Healthy
}
return &VirtualGPUPlugin{
deviceIDs: devices,
health: healthMap,
updateCh: make(chan struct{}),
}
}
// ListAndWatch 返回当前可用的设备,使用 grpc 的流式rpc
func (p *VirtualGPUPlugin) ListAndWatch(_ *pluginapi.Empty, s pluginapi.DevicePlugin_ListAndWatchServer) error {
for {
// 第一次调用时发一次,之后每次变化时全量发
err := s.Send(&pluginapi.ListAndWatchResponse{Devices: p.getDevice()})
if err != nil {
return err
}
select {
case <-p.updateCh:
case <-s.Context().Done():
// 直到 stream 关闭退出
return nil
}
}
}
func (p *VirtualGPUPlugin) getDevice() []*pluginapi.Device {
devices := make([]*pluginapi.Device, 0, len(p.deviceIDs))
for _, id := range p.deviceIDs {
devices = append(devices, &pluginapi.Device{
ID: id,
Health: p.health[id],
})
}
return devices
}
// Allocate 按容器为单位申请设备,在req中可以指定对容器的操作(mount设备、写环境变量等)
func (p *VirtualGPUPlugin) Allocate(ctx context.Context, req *pluginapi.AllocateRequest) (
*pluginapi.AllocateResponse, error) {
p.mu.Lock()
defer p.mu.Unlock()
resp := &pluginapi.AllocateResponse{}
for _, v := range req.GetContainerRequests() {
for _, id := range v.GetDevicesIds() {
if _, ok := p.health[id]; !ok {
return nil, fmt.Errorf("device %s not found", id)
}
if p.health[id] != pluginapi.Healthy {
return nil, fmt.Errorf("device %s is unhealthy", id)
}
}
klog.Infof("allocated devices %v", v.GetDevicesIds())
resp.ContainerResponses = append(resp.ContainerResponses, &pluginapi.ContainerAllocateResponse{
// 注入环境变量
Envs: map[string]string{
EnvAssigned: strings.Join(v.GetDevicesIds(), ","),
},
})
}
return resp, nil
}剩下这三个方法只需要空实现即可:
// 不需要实现
func (p *VirtualGPUPlugin) GetDevicePluginOptions(context.Context, *pluginapi.Empty) (*pluginapi.DevicePluginOptions, error) {
return &pluginapi.DevicePluginOptions{}, nil
}
func (p *VirtualGPUPlugin) GetPreferredAllocation(context.Context, *pluginapi.PreferredAllocationRequest) (*pluginapi.PreferredAllocationResponse, error) {
return &pluginapi.PreferredAllocationResponse{}, nil
}
func (p *VirtualGPUPlugin) PreStartContainer(context.Context, *pluginapi.PreStartContainerRequest) (*pluginapi.PreStartContainerResponse, error) {
return &pluginapi.PreStartContainerResponse{}, nil
}
实现完插件本体,还需要:
在 device-plugin 目录创建并监听自己的 socket,同时能处理 kubelet 重启
调用 kubelet 的 socket,发注册插件 rpc
const endpoint = "virtual-gpu.sock" // 放在 pluginapi.DevicePluginPath 下
func main() {
n := flag.Int("devices", 4, "number of virtual devices")
flag.Parse()
plugin := plugin.NewPlugin(*n)
ctx, stop := signal.NotifyContext(context.Background(), syscall.SIGINT, syscall.SIGTERM)
defer stop()
for ctx.Err() == nil {
if err := runAndHold(ctx, plugin); err != nil {
klog.Errorf("runAndHold err: %v, restart in 3 seconds", err)
}
select {
case <-ctx.Done():
case <-time.After(3 * time.Second): // 等3秒后重试
}
}
}
// runAndHold 启动 device-plugin 并卡住,处理 kubelet 重启
func runAndHold(ctx context.Context, p *plugin.VirtualGPUPlugin) error {
// 在 kubelet 的 device-plugin 目录创建 socket
sock := filepath.Join(pluginapi.DevicePluginPath, endpoint)
_ = os.Remove(sock) // 清掉上次遗留的文件
listener, err := net.Listen("unix", sock)
if err != nil {
return err
}
srv := grpc.NewServer()
pluginapi.RegisterDevicePluginServer(srv, p)
go srv.Serve(listener)
defer srv.Stop()
klog.Infof("listening on %s", sock)
if err := register(ctx); err != nil {
klog.Errorf("register device-plugin err: %v", err)
return err
}
klog.Infof("registered %v with kubelet succ", plugin.ResourceName)
// 卡住,并定时检查 socket 是否还存在(kubelet重启)
tick := time.NewTicker(2 * time.Second)
defer tick.Stop()
for {
select {
case <-ctx.Done():
return nil
case <-tick.C:
// kubelet重启时会把 device-plugins 目录清空,需要重新注册
if _, err := os.Stat(sock); err != nil {
log.Printf("device-plugin socket is gone, re-registering")
return err
}
}
}
}
// 向 kubelet 注册插件
func register(ctx context.Context) error {
conn, err := grpc.NewClient("unix://"+pluginapi.KubeletSocket,
grpc.WithTransportCredentials(insecure.NewCredentials()))
if err != nil {
return err
}
defer conn.Close()
registerCtx, cancel := context.WithTimeout(ctx, 10*time.Second)
defer cancel()
_, err = pluginapi.NewRegistrationClient(conn).Register(registerCtx, &pluginapi.RegisterRequest{
Version: pluginapi.Version,
Endpoint: endpoint,
ResourceName: plugin.ResourceName,
})
return err
}Kubelet 有可能重启,重启会导致 device-plugins 目录被清空。插件有义务发现这种情况,然后主动重新执行注册。这里使用一个 loop 来做。同时也需要在部署的时候 mount 母机对应目录到容器中。
写对应的 dockerfile,然后写对应的 daemonset yaml 来部署:
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: virtual-gpu-device-plugin
  namespace: kube-system
  labels:
    app: virtual-gpu-device-plugin
spec:
  selector:
    matchLabels:
      app: virtual-gpu-device-plugin
  template:
    metadata:
      labels:
        app: virtual-gpu-device-plugin
    spec:
      containers:
        - name: device-plugin
          image: unicore/virtual-gpu-device-plugin:dev
          imagePullPolicy: IfNotPresent
          args:
            - -devices=4
          resources:
            requests:
              cpu: 50m
              memory: 50Mi
            limits:
              memory: 100Mi
          volumeMounts:
            # socket 与 kubelet 注册地址都固定在 DevicePluginPath,必须挂宿主机目录
            - name: device-plugins
              mountPath: /var/lib/kubelet/device-plugins
      volumes:
        - name: device-plugins
          hostPath:
            path: /var/lib/kubelet/device-plugins
            type: Directory
测试
打镜像,在集群部署。看一下 pod 日志:
$ kubectl logs virtual-gpu-device-plugin-4d4t2 -n kube-system
I1101 06:36:31.932949       1 main.go:55] listening on /var/lib/kubelet/device-plugins/virtual-gpu.sock
I1101 06:36:31.947961       1 main.go:61] registered unicore.mcyou.cc/gpu with kubelet succ
成功注册了。这时 get node 资源可以看到新增了我们定义的资源类型:
 kubectl get node kind-worker -o yaml
...
  allocatable:
    cpu: "4"
    memory: 7869660Ki
    pods: "110"
    unicore.mcyou.cc/gpu: "4"
最后就是实际申请资源测试了。写一个 pod 申请 vgpu 资源:
apiVersion: v1
kind: Pod
metadata:
  name: vgpu-demo
  labels:
    app: vgpu-demo
spec:
  containers:
    - name: demo
      image: alpine:3.20
      imagePullPolicy: IfNotPresent
      command:
        - /bin/sh
        - -c
        - |
          echo "assigned virtual gpus: ${VIRTUAL_GPU_IDS}"
          sleep infinity
      resources:
        limits:
          unicore.mcyou.cc/gpu: 3
        requests:
          unicore.mcyou.cc/gpu: 2
部署后,可以在 pod 输出看到由插件注入的环境变量,并在 pod 信息看到其资源使用:
$ kubectl logs vgpu-demo
assigned virtual gpus: fake-0,fake-1
$ kubectl describe pod vgpu-demo
...
Limits:
unicore.mcyou.cc/gpu: 2
Requests:
unicore.mcyou.cc/gpu: 2